川柳APIでできることを知ろう
今日の目標!
- 川柳APIがどんなデータを扱うか知る
- GETとPOSTの役割の違いを知る
川柳を部品に分けてみよう
これから作るのは、集めた言葉を組み合わせて川柳を作るWebアプリだよ。
川柳は、五・七・五の音のリズムで、身近な出来事や気持ちを表す短い詩。最初の五音を上五(かみご)、次の七音を中七(なかしち)、最後の五音を下五(しもご)と呼ぶんだ。
| 位置 | 句の例 |
|---|---|
| 上五 | イケメンだ |
| 中七 | さすがリッキー |
| 下五 | かっこいい |
※「文字の数」と「音の数」は同じとは限らないよ。たとえば「しゅ」は2文字で1音。字余りや字足らずというのもある。今回のプログラムでは音の数を自動判定しないので、声に出して確かめよう。
それぞれの位置にいくつも句を集め、1つずつ選ぶと、思いがけない組み合わせができる。
意味がつながったり、ちょっと変な川柳になったりするのも楽しみだね。
川柳APIの役割
第1回のPokeAPIでは、ポケモンのデータを受け取ったね。
今回使用する川柳APIは、句を登録したり、集めた句から作った川柳を受け取ったりするための窓口だよ。
| できること | リクエストメソッド | URLのパス |
|---|---|---|
| 登録されている句を受け取る | GET | /v1/parts |
| 上五だけを受け取る | GET | /v1/parts?position=upper |
| 句を1つ登録する | POST | /v1/parts |
| ランダムな川柳を受け取る | GET | /v1/senryu/random |
リクエストメソッドは、リクエストで「どんな操作をしたいか」を伝えるもの。今回は、GETを「見せて」、POSTを「この内容を送るよ」と考えよう。同じ/v1/partsでも、メソッドによって処理が変わるんだ。
送るデータ(リクエスト)と返ってくるデータ(レスポンス)
ポケモンAPIを叩いたとき、JSON(ジェイソン)という、pythonでいう辞書型のようなデータが出てきたのを覚えてるかな?
川柳APIへ句を登録するときは、こんな感じのJSONを送るよ
{
  "text": "イケメンだ",
  "position": "upper"
}
textは句の文章、positionは句の位置を表すよ。
positionの値 |
意味 |
|---|---|
upper |
上五 |
middle |
中七 |
lower |
下五 |
上五・中七・下五がそろっていれば、GET /v1/senryu/randomで次のようなJSONを受け取れる。
{
  "upper": "イケメンだ",
  "middle": "さすがリッキー",
  "lower": "かっこいい",
  "senryu": "イケメンだ\nさすがリッキー\nかっこいい"
}
これはレスポンスの例なので、実際の句は登録内容によって変わるよ。\nは改行を表す記号。PythonでJSONを読み込んでprint(data["senryu"])とすると、3行に分かれて表示される。
川柳APIのドキュメントを読んでみよう
みんなは、新しいモノを買ったときについてくる説明書って、読む?
昔のゲームソフトには、ソフトのはこの中にこんな感じの説明書がついていたんだ
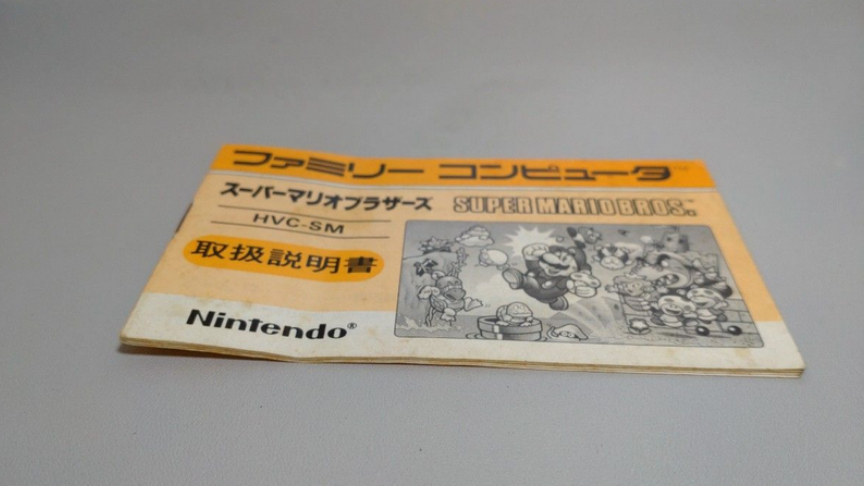
なんでこんなのがついてたかというと、昔のゲームソフトの容量が少なくて、今で言う操作チュートリアルとかを入れる余裕がなかったり、今のゲームみたいにネットに繋いで、不具合があればアップデート、みたいなことはできなかったから、操作方法とかをきちんと伝えておかないといけなかったり。あと今ほど「説明書がないと操作がわからないような設計はダメ」という考え方が浸透していなかった、というのもある。
プログラミングの世界で「このツール・アプリの使い方」が書かれたページやファイルを「ドキュメント」と呼ぶよ。今回使う川柳APIにもドキュメントがあるので、読んでみよう
AIの時代は文字を読む力がめちゃ大事
AIになにか聞いてみたことがある人はわかると思うけど、何かを説明させると、とても丁寧に説明してくれたりする。でも、その説明をよく読まなかったり、何も考えずに信じたりすると、大きな間違いに気づけなかったりする。
ドキュメントは、基本的にはそのアプリなどを作った人が書いている場合が多いので、一番信頼のおける情報が書いてある。丁寧な場合は初心者用の使い方ガイドを書いてあることもあるし、裏ワザ的な使い方が書いてあったりすることもあるので、読んでみると意外とおもしろい!
ドキュメントを読むときのコツ
ドキュメントを読むと、難しい専門用語や英単語が出てきて、最初は面食らうと思う。読み方のコツとしては
- 何度も出てくる単語で、わからないものを調べてみる
- 最初に地の文をざっくり読んでみる
- ときにはAIに「これどういう意味?わかりやすく説明して」みたいに聞いてみるのも大事
/docsでAPIを叩いてみよう
先生から案内された川柳APIのURLに、/docsを付けたページを開いてみよう。
GET /v1/partsを開き、Try it out、Executeの順に押す。- レスポンスの本文で、
textとpositionを探す。まだ登録がなければ[]が返るよ。 - 上五・中七・下五が登録済みなら、
GET /v1/senryu/randomも実行する。 - JSONの
upper、middle、lowerが、どの句に対応するか確認する。
APIのURLは先生から案内してもらおう。APIを使えない場合は、上のJSON例でデータの形を確認して、次の実習へ進めるよ。
句が足りないときは、川柳の代わりにHTTP 409と、不足している位置を知らせるメッセージが返る。エラーもAPIからのレスポンスなんだ。
pythonで実行してみよう
最終的にはwebサイトにするんだけど、その前に、APIを叩いて実際にデータを取れているか確認してみよう
import requests

BASE_URL = "https://rickysensei.pythonanywhere.com"

response = requests.get(f"{BASE_URL}/v1/senryu/random")

print(response.status_code)
print(response.json())
URLを変えて見よう
川柳APIがどういう動きをするかは、URLとリクエストメソッドの組み合わせによって決まるよ
URL = "https://rickysensei.pythonanywhere.com/動きを決める部分"
そして、動きによっては、他に必要になってくる情報もあるから、/docs やドキュメントを見ながら、URLを変えて試してみよう
例:上の句を登録する
※「古池や」がすでに登録済みだと、どうなるかな?まずは自分の言葉に変えてやってみて、その後で登録済みの単語をもう一度登録してみよう
import requests

BASE_URL = "https://rickysensei.pythonanywhere.com"
part = {
    "text": "古池や",
    "position": "upper"
}

response = requests.post(
    f"{BASE_URL}/v1/parts",
    json=part
)

print(response.status_code)
print(response.json())
確認してみよう
- 登録済みの句を受け取るときは、GETとPOSTのどちらを使う?
positionがmiddleの句は、川柳のどこに使われる?
演習
川柳APIからランダムな句を一つ取得して、ターミナルにこんな感じで出力しよう
上五:リッキーは
中七:今日もとっても
下五:かっこいい